5 つの測定値から、川の水質を読み解く。
WaterMirror は溶存酸素、BOD、アンモニア態窒素、電気伝導度、浮遊物質から、WQI5 スコアと水質ランク、指標ごとの状態を求めます。Android アプリで使うことも、オープン API を呼び出すことも、サービス全体を Jetson Nano で動かすこともできます。
- Android アプリ 2.3.7
- API 2.3.0(PyPI)
- x86 と ARM64 に対応
- DO
- 溶存酸素
- % 飽和度
- BOD
- 生物化学的酸素要求量
- mg/L
- NH₃-N
- アンモニア態窒素
- mg/L
- EC
- 電気伝導度
- µS/cm
- SS
- 浮遊物質
- mg/L
アプリでできること
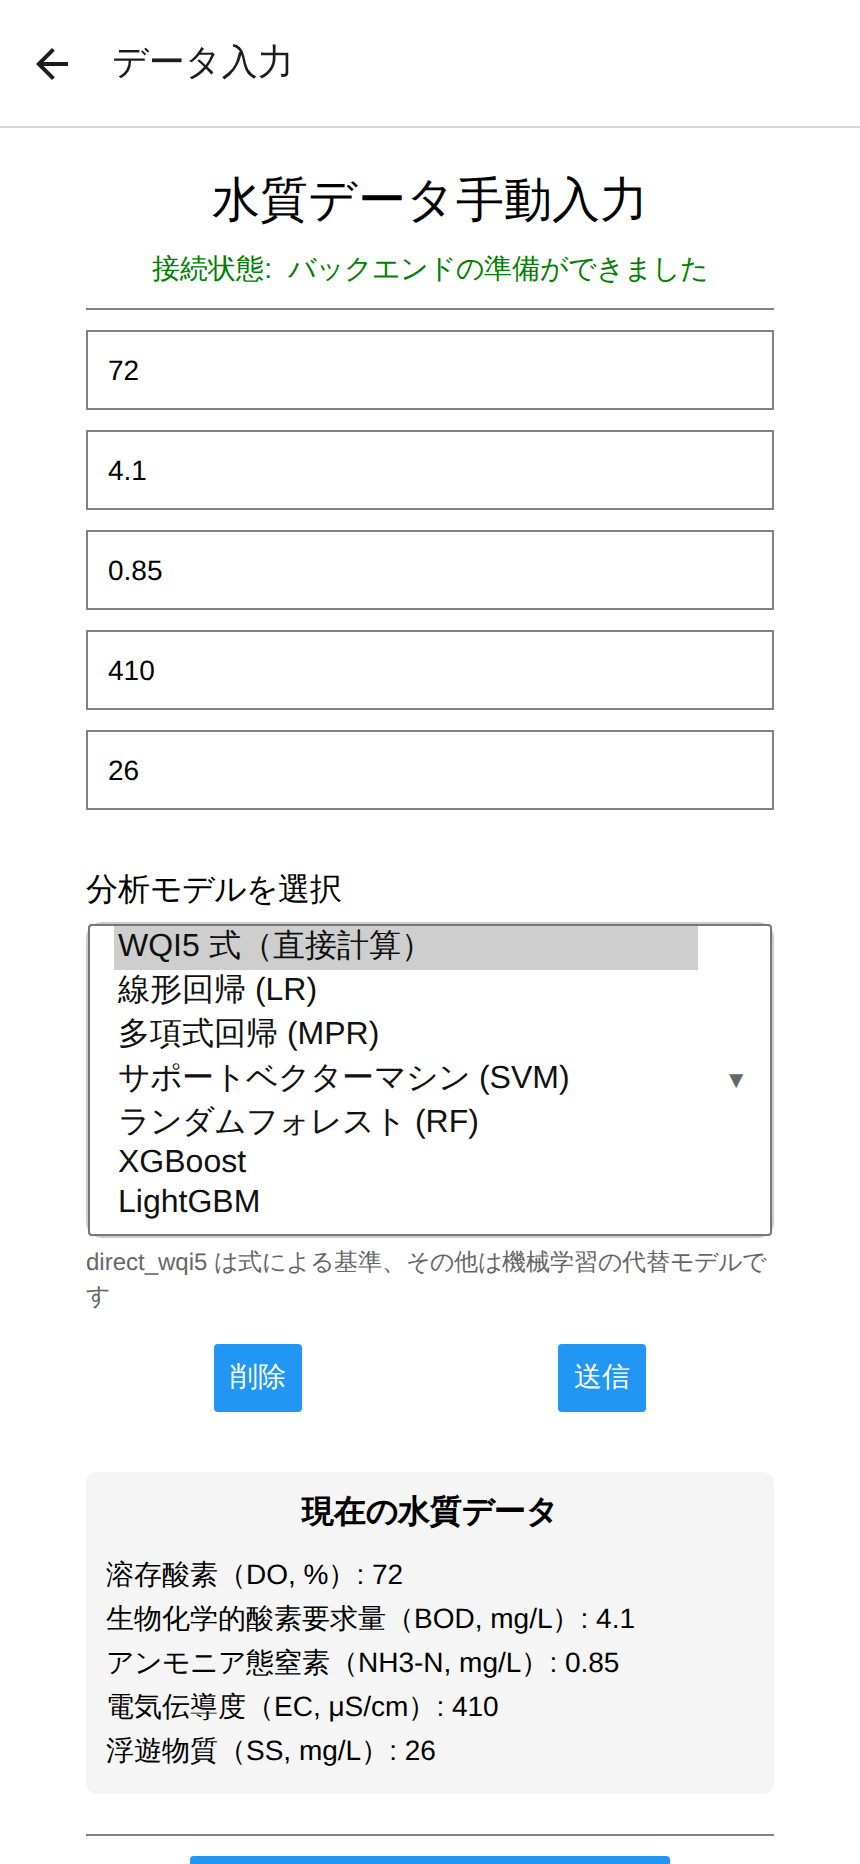
測定値を入力、または CSV をアップロード
5 つの値を手入力するか、ヘッダーが
DO,BOD,NH3N,EC,SSの CSV をアップロードして、まとめて評価できます。スコアの計算方法を選ぶ
WQI5 の式で直接計算するか、学習済みの 6 つのモデル(線形回帰、多項式回帰、SVM、ランダムフォレスト、XGBoost、LightGBM)と比較できます。
スコアの意味がわかる
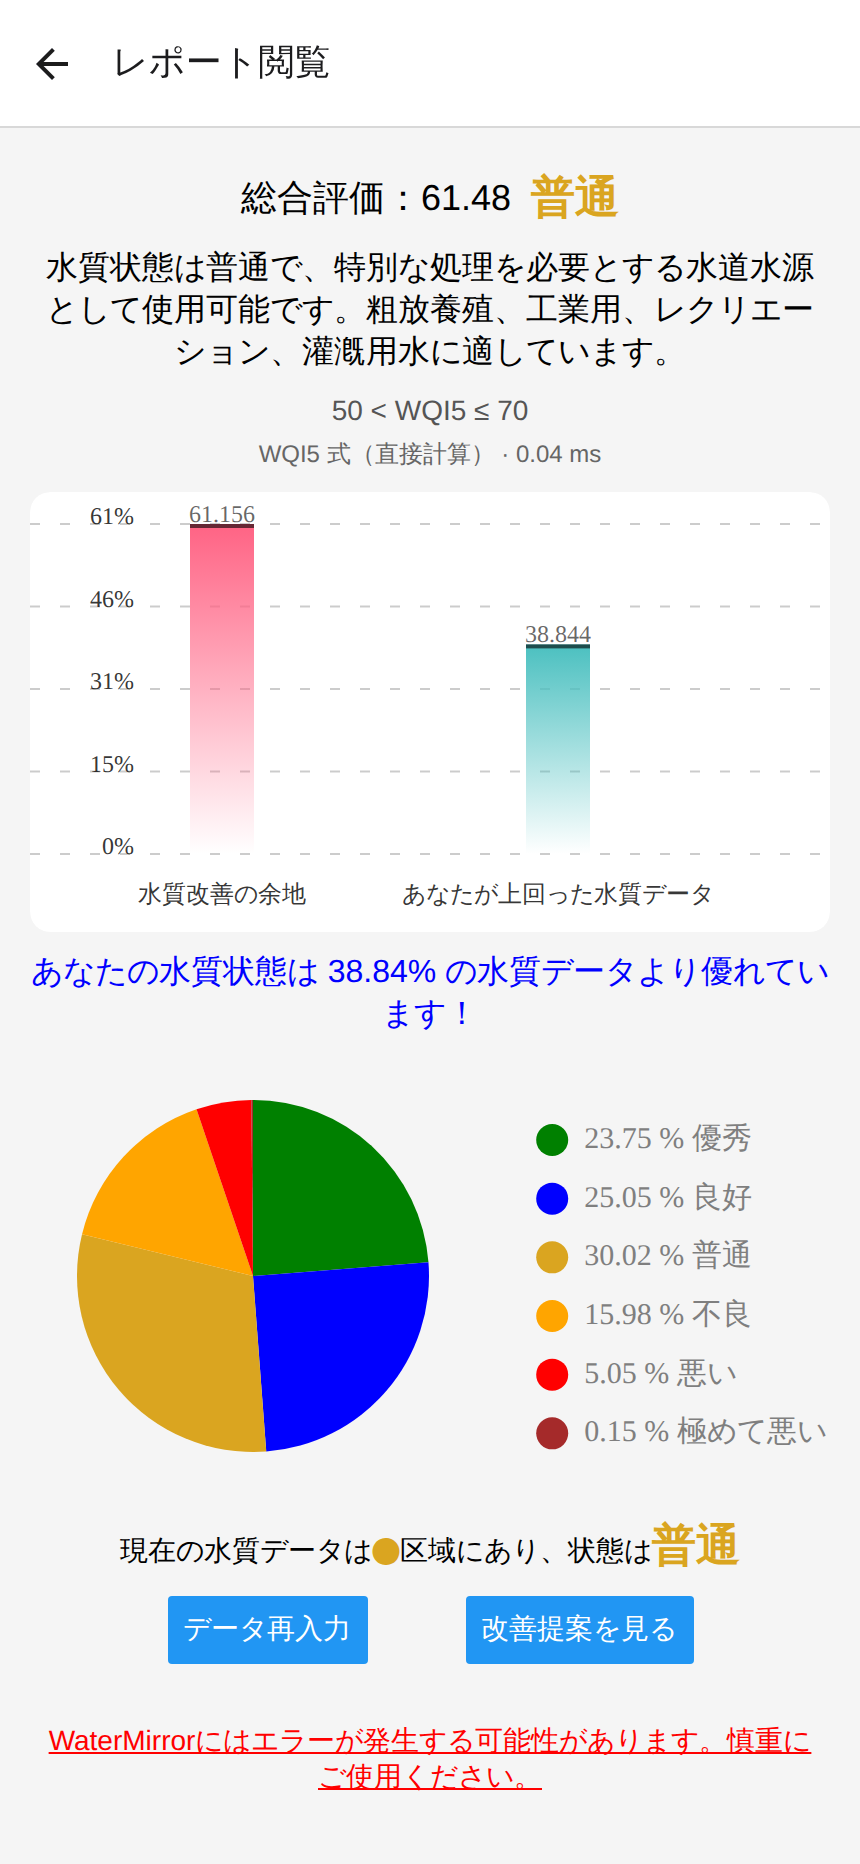
レポートには、スコア、ランクとスコア範囲、指標ごとの評価、参照データの中での位置(パーセンタイル)、入力に関する警告が表示されます。
自分のサーバーにつなぐ
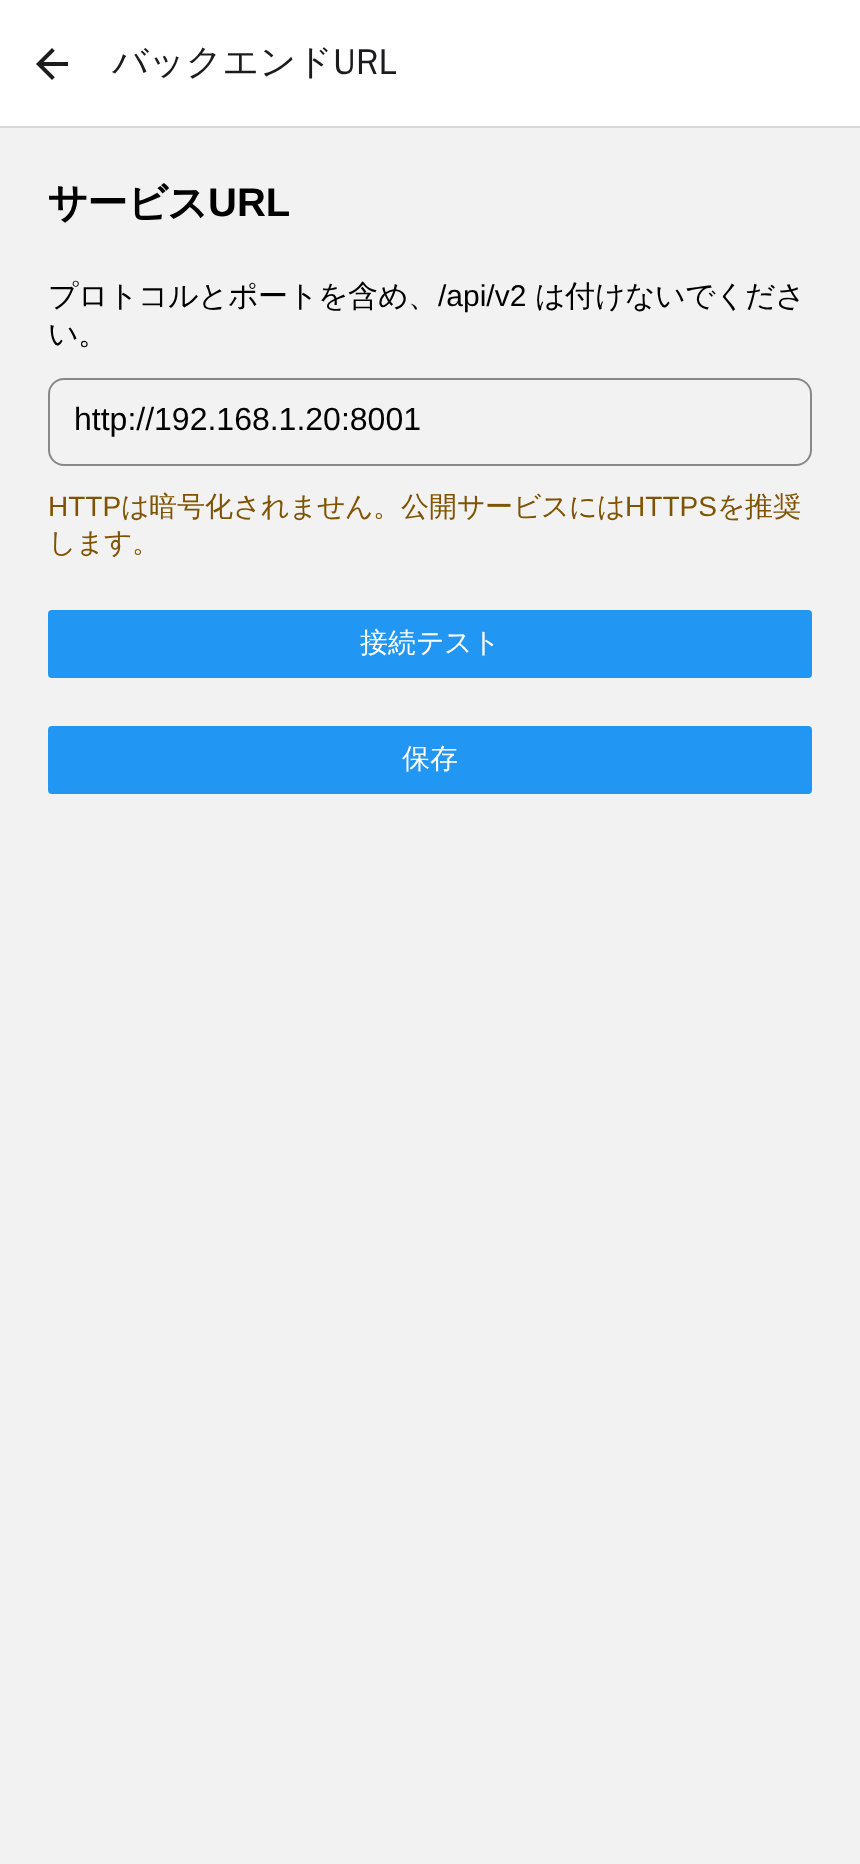
「バックエンド設定」でバックエンドのアドレスを入力し、データを送る前にヘルスチェックと準備状態を確認できます。アドレスは端末に保存されます。
4 つの言語に対応
英語、繁体字中国語、簡体字中国語、日本語。
測定値がスコアになるまで
- 1
測定
採水地点で DO、BOD、NH₃-N、EC、SS を測ります。
- 2
送信
アプリが値を WQSurrogateModels API の
/api/v2/assessmentに送ります。 - 3
評価
API が入力を検証し、式または選んだモデルで WQI5 を計算します。
- 4
確認
API が返したスコア、ランク、スコア範囲、指標ごとの状態、警告をアプリが表示します。
WQI5 の式
各指標を 0〜100 のサブ指数に換算し、5 つのサブ指数を同じ重みで平均したものが WQI5 です。小数点以下 3 桁に丸めます。
WQI5 = (QDO + QBOD + QNH₃-N + QEC + QSS) ÷ 5
アプリ自体はスコアを計算しません。結果はすべて API が決めるため、どのクライアントでも同じ答えになります。
WaterMirror アプリ
Expo と React Native で作った Android アプリ
WQSurrogateModels API
式と学習済みモデルを提供する FastAPI サービス
API の実行環境
一般的な x86 サーバーや PC
Docker で動く Jetson Nano 2GB(ARM64)
6 つのランクと、それぞれの用途
API はすべてのスコアを 6 つのランクのいずれかに分類し、アプリがそのランクの水に適した用途を説明します。
| 優秀85 < WQI5 ≤ 100 | あらゆる用途に使えます。塩素消毒すれば飲用できます。 |
|---|---|
| 良好70 < WQI5 ≤ 85 | 水道水源のほか、水産、工業、レクリエーション、かんがいに使えます。 |
| 普通50 < WQI5 ≤ 70 | 特別な処理をすれば水道水源になります。水質への要求が低い魚の養殖、工業、レクリエーション、かんがいに使えます。 |
| 不良30 < WQI5 ≤ 50 | かんがいや工業用の冷却水にのみ適しています。 |
| 悪い15 < WQI5 ≤ 30 | 不快感を与えるほどではなく、環境保全に利用できます。 |
| 極めて悪い0 ≤ WQI5 ≤ 15 | 悪臭が発生するおそれがあります。 |
式が基準。モデルは比較のために。
5 つの測定値がそろっているときは、WQI5 の式が既定の方法であり基準です。式を近似する 6 種類の回帰モデルも学習させ、精度と計算コストを比べられるようにしました。指標が欠けた状況の実験にも使っています。
| モデル | MAE | R² |
|---|---|---|
| XGBoost | 0.264 | 0.9996 |
| LightGBM | 0.288 | 0.9995 |
| Random Forest | 0.338 | 0.9990 |
| SVM | 1.916 | 0.9813 |
| Polynomial regression | 5.160 | 0.8995 |
| Linear regression | 7.556 | 0.7803 |
5 回の繰り返し分割の平均です。誤差はデータセットの Score 列に対して計算しています。式そのものも Score 列とずれがあり(MAE 6.07)、原因は調査中です。そのため、モデルの誤差が小さくても、式より正しいとは言えません。
研究用データセットと学習済みモデルのファイルは公開していません。式はそのまま使えますが、モデルはローカルで用意する必要があります。
指標が 1 つ欠けたとき
式は 5 つの測定値がそろわないと使えません。しかし BOD の測定には 5 日間の室内試験が必要で、アンモニア態窒素もふつうは試験室で分析するため、現場のデータは欠けがちです。研究では 2 つの方法を試しました。手元の指標だけでモデルを学習し直す方法と、欠けた指標をほかの指標から先に補ってから評価する方法です。どちらも、学習に使っていない 10,714 件のデータで検証しました。
NH₃-N が欠けた場合
使う指標:DO、BOD、EC、SS
推定値として使える
- 欠けた指標なしで再学習
- MAE 2.37R² 0.95
- ほかの指標から先に補完
- MAE 2.40R² 0.95
BOD が欠けた場合
使う指標:DO、NH₃-N、EC、SS
信頼できない
- 欠けた指標なしで再学習
- MAE 14.12R² −0.02
- ほかの指標から先に補完
- MAE 12.14R² 0.10
BOD と NH₃-N が欠けた場合
使う指標:DO、EC、SS
信頼できない
- 欠けた指標なしで再学習
- MAE 14.72R² −0.14
- ほかの指標から先に補完
- MAE 12.89R² −0.01
MAE は WQI5 のスコア単位で、小さいほど良い値です。R² が 0 未満なら、常に平均値を答えるより悪いことを意味します。
アンモニア態窒素は、ほかの 4 指標から約 2.4 ポイントの誤差で推定できます。BOD はできません。BOD がないと誤差は 12〜15 ポイントに広がるため、BOD は必ず測るべき指標です。
以上は研究結果です。現在のアプリと API は、5 つの指標がそろったデータだけを評価します。
2 GB の Jetson Nano で実機検証
同じ API を Docker で Jetson Nano 2GB(4 コア Cortex-A57)上に載せ、CPU だけで推論しています。モデルの学習はデバイス上では行いません。
| 計算方法 | 95 パーセンタイル | 中央値 |
|---|---|---|
| Direct WQI5 | 7.42 ms | 6.41 ms |
| XGBoost | 17.42 ms | 15.52 ms |
| LightGBM | 17.57 ms | 15.67 ms |
| Random Forest | 163.81 ms | 146.90 ms |
ウォームアップ後の 1 行ずつの HTTP リクエスト、デバイス内のループバック経由、MAXN 電源モード、各方法 300 回。モデルのコールドロードは別に測定しています。
610 件中 597 件
再実行結果が x86 と一致
実験一式を Nano で再実行し、絶対誤差 1e-6 を基準に x86 と比較しました。一致しなかった 13 件は、いずれも欠測指標を再構成する条件の線形・多項式モデルで、悪条件の係数がごく小さな浮動小数点の差を増幅していました。
2.1.4 → 3.2.0
誤ったスコアを検出
Nano への最初のデプロイでは XGBoost 2.1.4 を使っていました。モデルはエラーなく読み込めたものの、スコアが誤っていました。x86 の参照結果との比較で見つかり、3.2.0 に固定して修正しました。
1.05 GB
最も重いのはランダムフォレスト
これは本番用ランダムフォレストのモデルファイルの大きさです。コールドロードに 168 秒かかり、メモリのピークは 1.2 GiB ですが、デバイスのメモリは 1.9 GiB しかありません。木を 200 本にした版はファイルが 3 分の 1 小さく、誤差の増加は 0.33% でした。完全な確認実験が終わるまでは候補のままです。
はじめる
アプリをインストール
APK をダウンロードして「バックエンド設定」を開き、動いている API のアドレス(例:http://192.168.1.20:8001)を入力します。
API を動かす
Python 3.10 以降が必要です。式だけを使う場合、モデルファイルは不要です。
git clone https://github.com/KageRyo/WQSurrogateModels.git
cd WQSurrogateModels
uv sync
uv run python main.py
ランタイムは PyPI でも wqsurrogatemodels として公開しています。
どこからでも呼び出せる
アプリと同じエンドポイントを、どの HTTP クライアントからも呼び出せます。
curl -X POST http://localhost:8001/api/v2/assessment \
  -H "Content-Type: application/json" \
  -d '{"DO":70,"BOD":2,"NH3N":0.3,"EC":400,"SS":10,
       "model_type":"direct_wqi5"}'

{"score": 75.685, "category": "Good",
 "rating_range": "70 < WQI5 ≤ 85", ...}