用五項水質指標,讀懂一條河的水質。
WaterMirror 把溶氧、生化需氧量、氨氮、導電度與懸浮固體換算成 WQI5 分數、水質等級,以及每項指標的狀態。你可以使用 Android App、呼叫開放 API,或把整套服務跑在 Jetson Nano 上。
- Android App 2.3.7
- API 2.3.0(PyPI)
- 支援 x86 與 ARM64
- DO
- 溶氧
- % 飽和度
- BOD
- 生化需氧量
- mg/L
- NH₃-N
- 氨氮
- mg/L
- EC
- 導電度
- µS/cm
- SS
- 懸浮固體
- mg/L
App 能做什麼
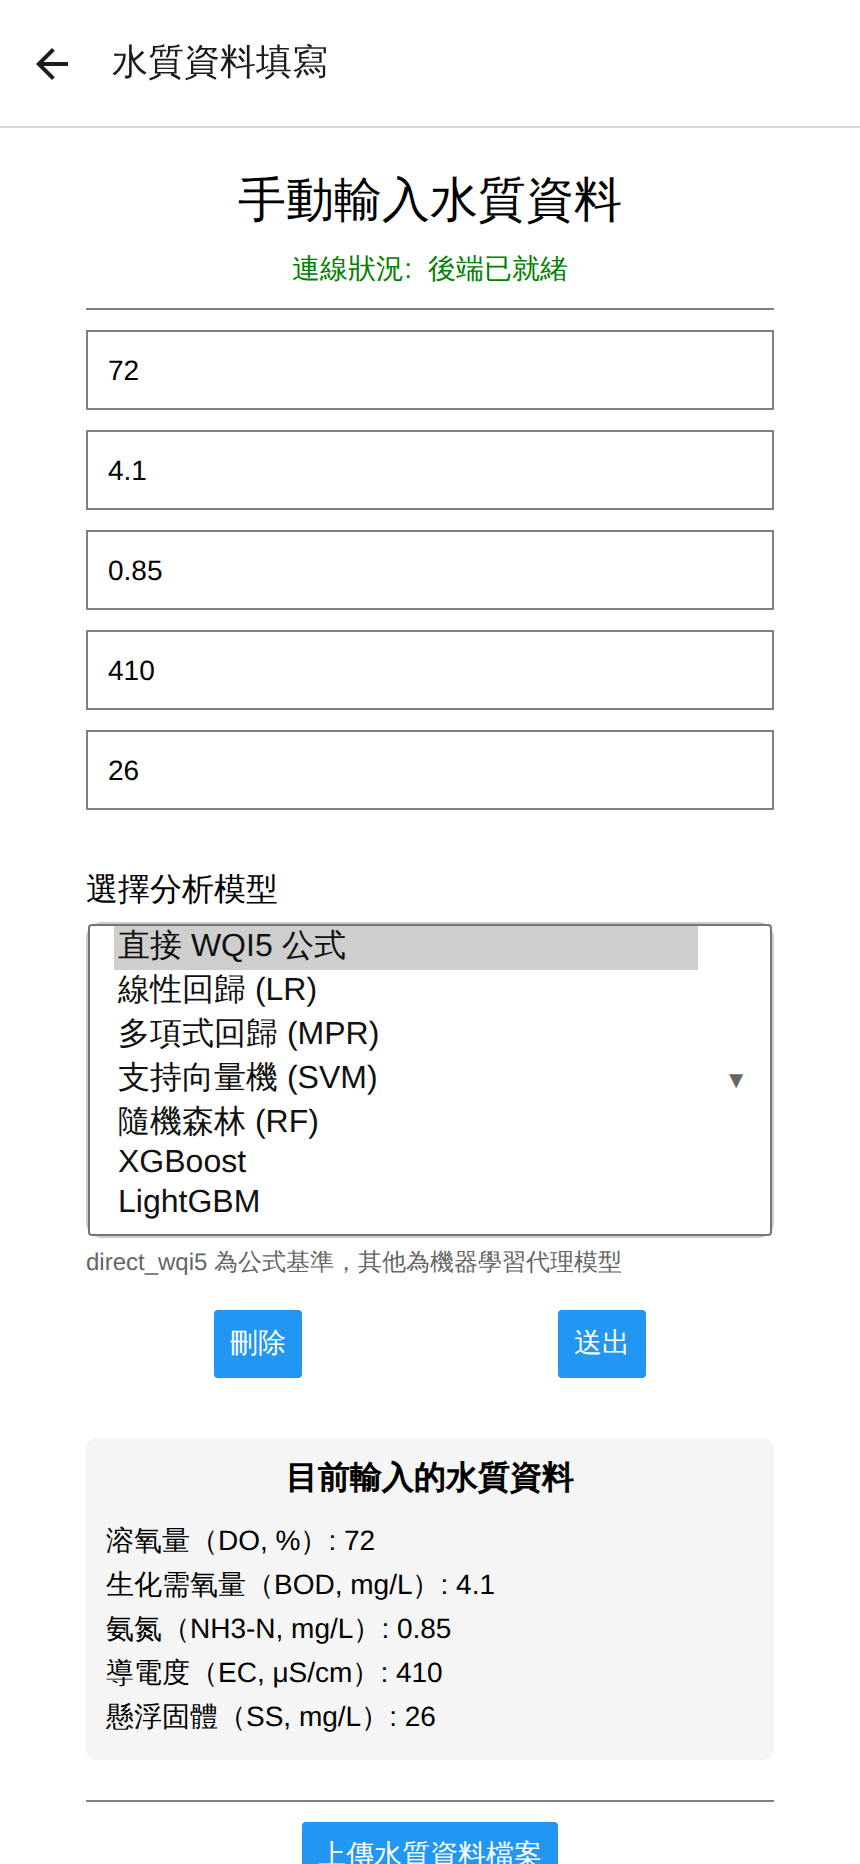
手動輸入或上傳 CSV
逐筆輸入五項數值,或上傳表頭為
DO,BOD,NH3N,EC,SS的 CSV,一次評估多筆資料。選擇計算方式
直接用 WQI5 公式計算,或改用六種訓練好的模型比較:線性回歸、多項式回歸、SVM、隨機森林、XGBoost、LightGBM。
看懂分數代表什麼
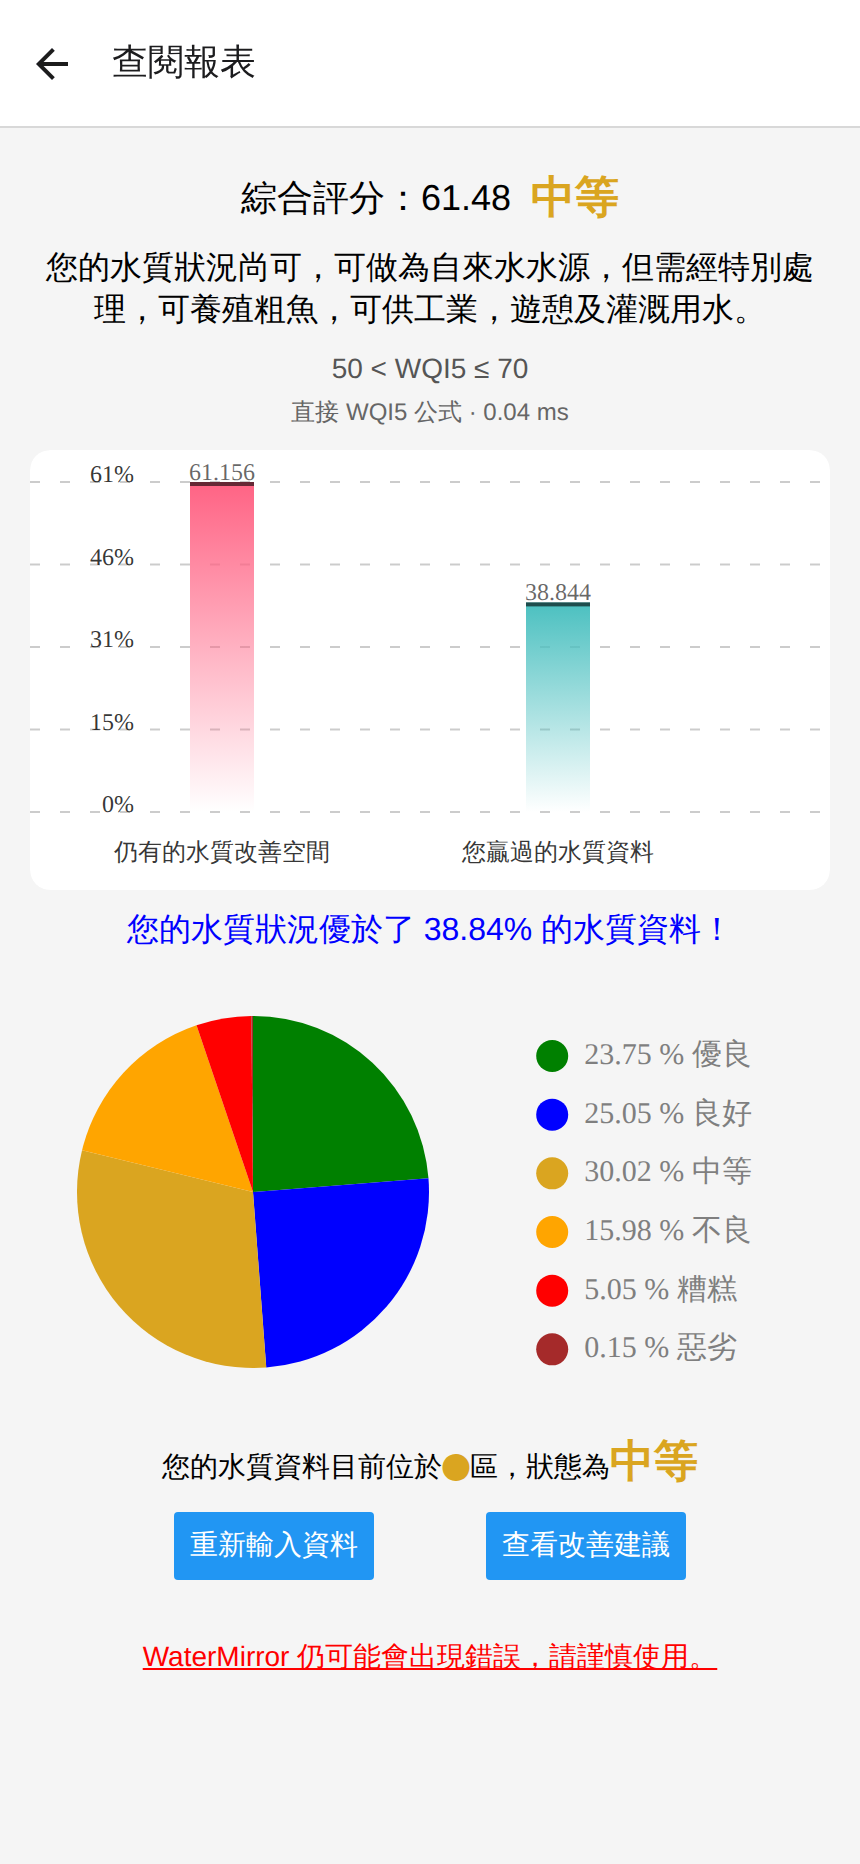
報表列出分數、等級與分數區間、各指標的評等、這筆資料在參考資料中的百分位,以及輸入警示。
連到自己的伺服器
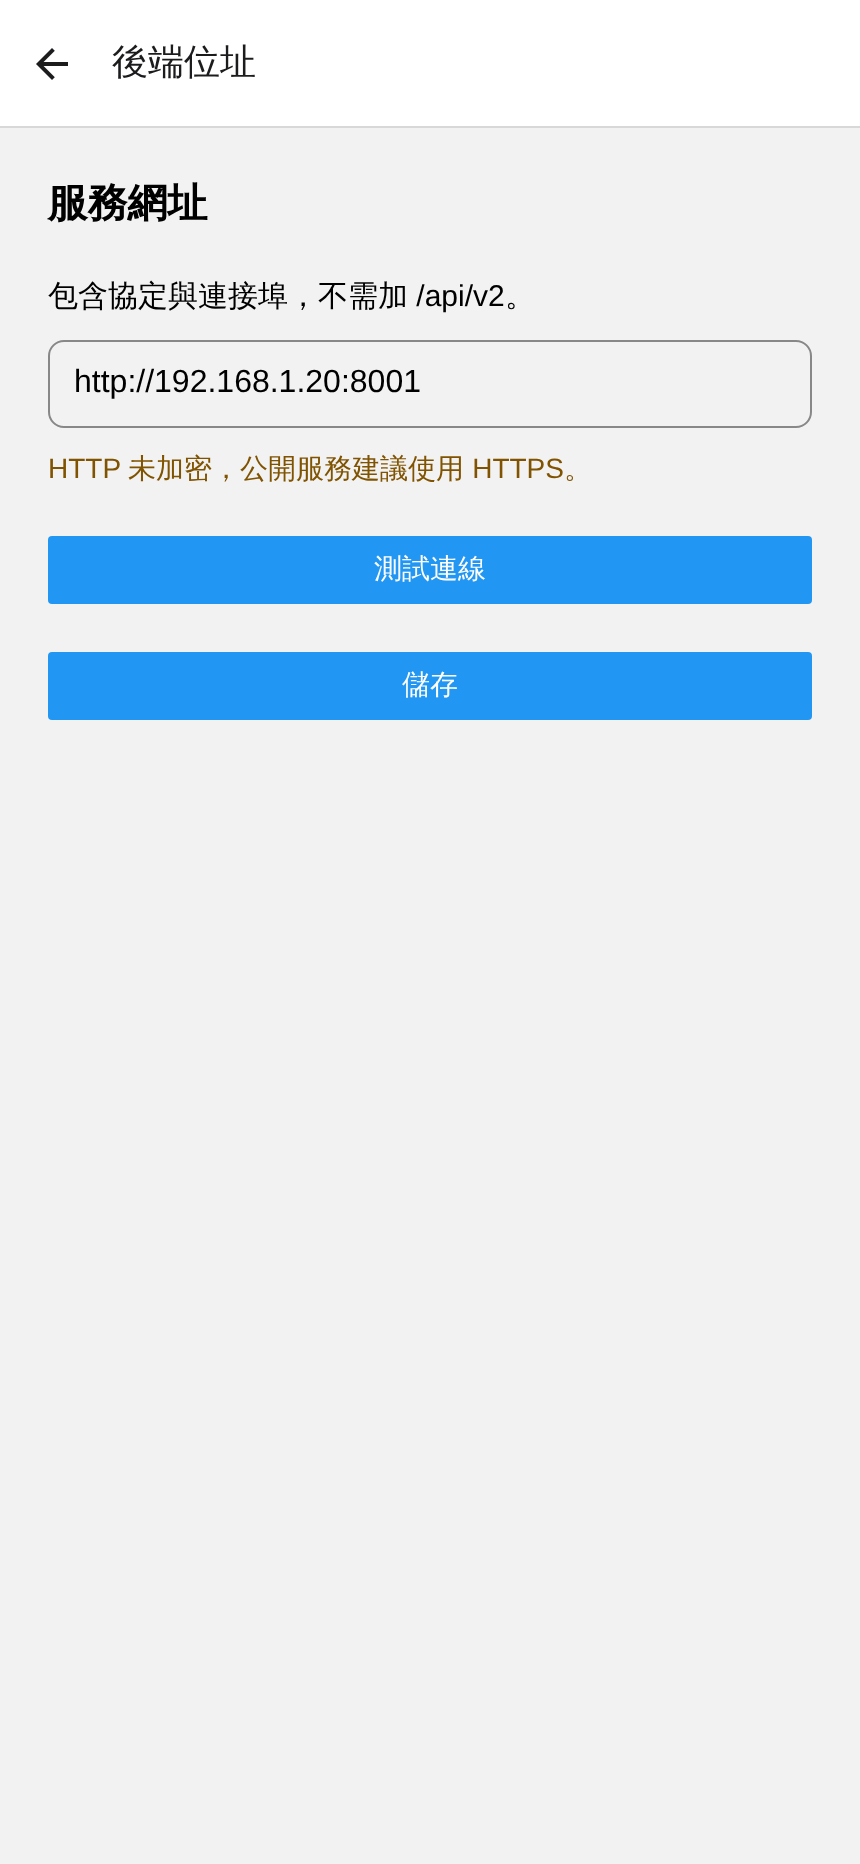
在「後端設定」輸入後端位址,送出資料前先測試健康與就緒狀態;位址會儲存在手機上。
支援四種語言
英文、繁體中文、簡體中文與日文。
一筆資料如何變成分數
- 1
量測
在採樣點取得 DO、BOD、NH₃-N、EC 與 SS。
- 2
送出
App 把數值送到 WQSurrogateModels API 的
/api/v2/assessment。 - 3
評估
API 檢查輸入後,用公式或你選的模型計算 WQI5。
- 4
判讀
App 顯示 API 回傳的分數、等級、分數區間、各指標狀態與警示。
WQI5 公式
每項指標先換算成 0 到 100 的子指數,WQI5 是五個子指數的等權平均,取到小數點後三位。
WQI5 = (QDO + QBOD + QNH₃-N + QEC + QSS) ÷ 5
App 本身不計算分數,一律以 API 的結果為準,所以每個用戶端拿到的答案都一樣。
WaterMirror App
以 Expo 與 React Native 開發的 Android App
WQSurrogateModels API
FastAPI 服務,提供公式與訓練好的模型
API 的執行環境
一般 x86 伺服器或電腦
以 Docker 執行的 Jetson Nano 2GB(ARM64)
六個等級,各有適用用途
API 會把每個分數歸入六個等級之一,App 再說明該等級的水適合哪些用途。
| 優良85 < WQI5 ≤ 100 | 可做各種用途,加氯消毒後可直接飲用。 |
|---|---|
| 良好70 < WQI5 ≤ 85 | 可作為自來水水源,以及水產、工業、遊憩與灌溉用水。 |
| 中等50 < WQI5 ≤ 70 | 經特別處理後可作為自來水水源;可養殖粗魚,並供工業、遊憩與灌溉用水。 |
| 不良30 < WQI5 ≤ 50 | 僅適合灌溉或工業冷卻。 |
| 糟糕15 < WQI5 ≤ 30 | 不會引起厭惡,可作環境保育用途。 |
| 惡劣0 ≤ WQI5 ≤ 15 | 可能產生臭味。 |
公式是基準,模型用來比較
五項指標齊全時,預設且作為基準的是 WQI5 公式。另外訓練了六種回歸模型來近似公式,用來比較準確度與運算成本,也用在缺少指標的實驗情境。
| 模型 | MAE | R² |
|---|---|---|
| XGBoost | 0.264 | 0.9996 |
| LightGBM | 0.288 | 0.9995 |
| Random Forest | 0.338 | 0.9990 |
| SVM | 1.916 | 0.9813 |
| Polynomial regression | 5.160 | 0.8995 |
| Linear regression | 7.556 | 0.7803 |
為五次重複切分的平均。誤差是對資料集的 Score 欄位計算;公式本身與該欄位也有差距(MAE 6.07),原因仍在調查,因此模型誤差較低不代表比公式更正確。
研究資料集與訓練好的模型檔不隨專案公開。公式可以直接使用;模型需自行在本機提供。
少了一項指標時
公式需要五項指標齊全,但 BOD 要做五天的實驗室檢驗,氨氮通常也要送實驗室分析,現場資料常常不完整。研究測試了兩種補救方式:只用手上的指標重新訓練模型,或先用其他指標把缺的那一項補回來再評分。兩種方式都在 10,714 筆模型訓練時沒看過的資料上驗證。
缺少 NH₃-N
使用 DO、BOD、EC、SS
可作為估計
- 不用它重新訓練
- MAE 2.37R² 0.95
- 先從其他指標補齊
- MAE 2.40R² 0.95
缺少 BOD
使用 DO、NH₃-N、EC、SS
不可靠
- 不用它重新訓練
- MAE 14.12R² −0.02
- 先從其他指標補齊
- MAE 12.14R² 0.10
缺少 BOD 與 NH₃-N
使用 DO、EC、SS
不可靠
- 不用它重新訓練
- MAE 14.72R² −0.14
- 先從其他指標補齊
- MAE 12.89R² −0.01
MAE 以 WQI5 分數計,越低越好。R² 低於 0 代表比一律猜平均分數還差。
氨氮可以從其他四項指標估回來,誤差約 2.4 分;BOD 不行,少了它誤差會升到 12 到 15 分,所以 BOD 是一定要量的指標。
以上為研究結果;目前 App 與 API 只對五項指標齊全的資料評分。
在 2 GB 的 Jetson Nano 上實測
同一套 API 以 Docker 跑在 Jetson Nano 2GB(四核 Cortex-A57)上,只用 CPU 推論,模型訓練不在裝置上進行。
| 計算方式 | 第 95 百分位 | 中位數 |
|---|---|---|
| Direct WQI5 | 7.42 ms | 6.41 ms |
| XGBoost | 17.42 ms | 15.52 ms |
| LightGBM | 17.57 ms | 15.67 ms |
| Random Forest | 163.81 ms | 146.90 ms |
暖機後的單筆 HTTP 請求,走裝置本機迴路,MAXN 電源模式,每種方式 300 次。冷啟動載入另外量測。
610 組中 597 組
重跑結果與 x86 一致
整套實驗在 Nano 上重跑,並以絕對誤差 1e-6 為門檻與 x86 比對。不一致的 13 組都是缺指標重建情境下的線性與多項式模型,係數病態,會放大極小的浮點差異。
2.1.4 → 3.2.0
抓到分數錯誤
第一次部署到 Nano 時用的是 XGBoost 2.1.4,模型能正常載入,分數卻是錯的。與 x86 參考結果比對時發現問題,改為固定 3.2.0 後修正。
1.05 GB
隨機森林最吃資源
這是正式版隨機森林的模型檔大小。冷啟動載入要 168 秒,記憶體峰值 1.2 GiB,而裝置只有 1.9 GiB。200 棵樹的版本檔案小了三分之一,誤差只多 0.33%,在完整確認實驗之前仍維持候選。
開始使用
安裝 App
下載 APK,打開「後端設定」,輸入正在運作的 API 位址,例如 http://192.168.1.20:8001。
架設 API
需要 Python 3.10 以上。只用公式時不需要任何模型檔。
git clone https://github.com/KageRyo/WQSurrogateModels.git
cd WQSurrogateModels
uv sync
uv run python main.py
執行套件也已發布到 PyPI:wqsurrogatemodels。
從任何程式呼叫
任何 HTTP 用戶端都能呼叫 App 使用的同一個端點。
curl -X POST http://localhost:8001/api/v2/assessment \
  -H "Content-Type: application/json" \
  -d '{"DO":70,"BOD":2,"NH3N":0.3,"EC":400,"SS":10,
       "model_type":"direct_wqi5"}'

{"score": 75.685, "category": "Good",
 "rating_range": "70 < WQI5 ≤ 85", ...}