用五项水质指标,读懂一条河的水质。
WaterMirror 将溶解氧、生化需氧量、氨氮、电导率和悬浮物换算为 WQI5 分数、水质等级以及每项指标的状态。你可以使用 Android 应用、调用开放 API,或把整套服务部署在 Jetson Nano 上。
- Android 应用 2.3.7
- API 2.3.0(PyPI)
- 支持 x86 和 ARM64
- DO
- 溶解氧
- % 饱和度
- BOD
- 生化需氧量
- mg/L
- NH₃-N
- 氨氮
- mg/L
- EC
- 电导率
- µS/cm
- SS
- 悬浮物
- mg/L
应用能做什么
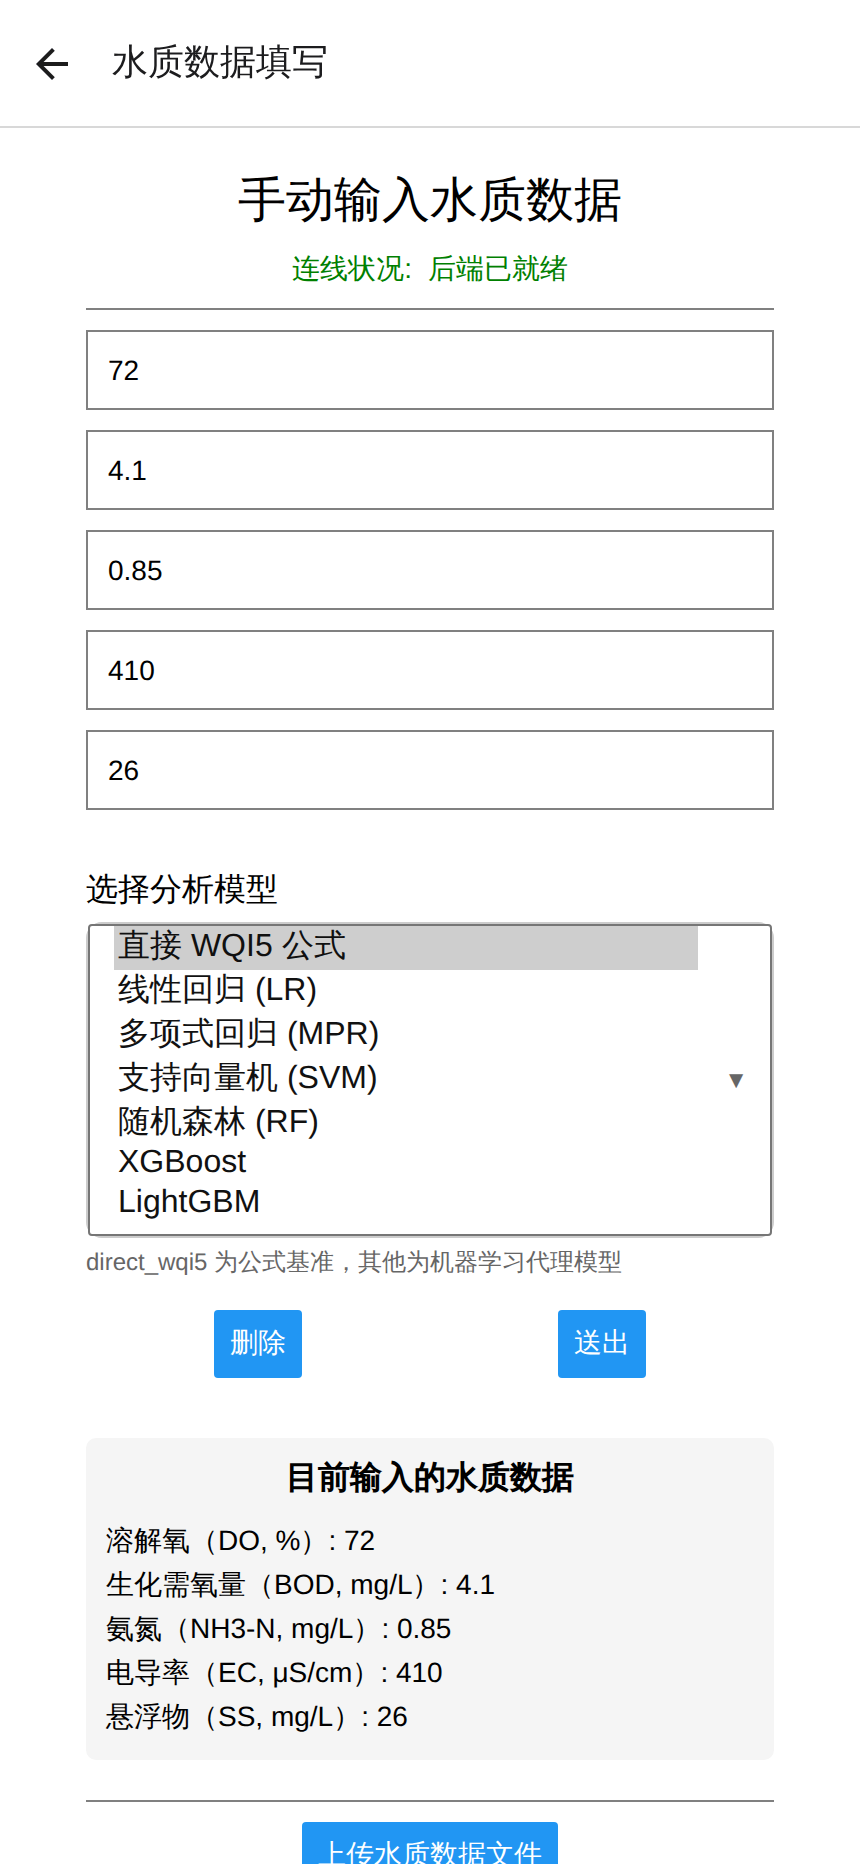
手动输入或上传 CSV
逐条输入五项数值,或上传表头为
DO,BOD,NH3N,EC,SS的 CSV 文件,批量评估多条数据。选择计算方式
直接用 WQI5 公式计算,或改用六种训练好的模型对比:线性回归、多项式回归、SVM、随机森林、XGBoost、LightGBM。
看懂分数的含义
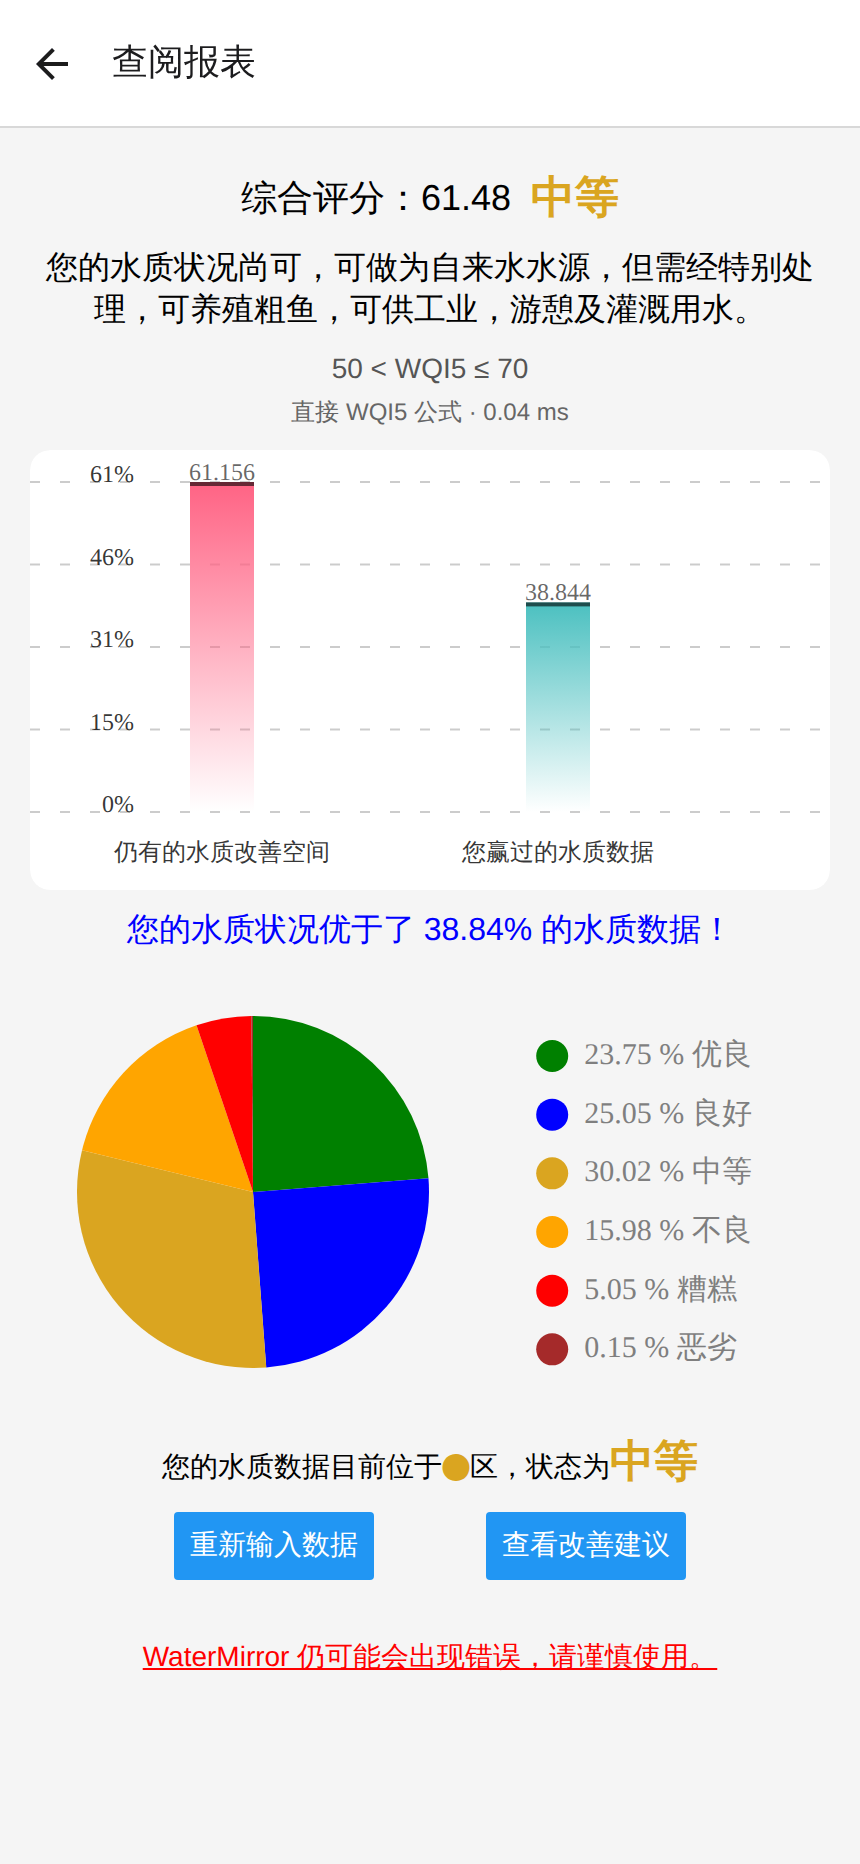
报表列出分数、等级和分数区间、各指标的评级、这条数据在参考数据中的百分位,以及输入警告。
连接自己的服务器
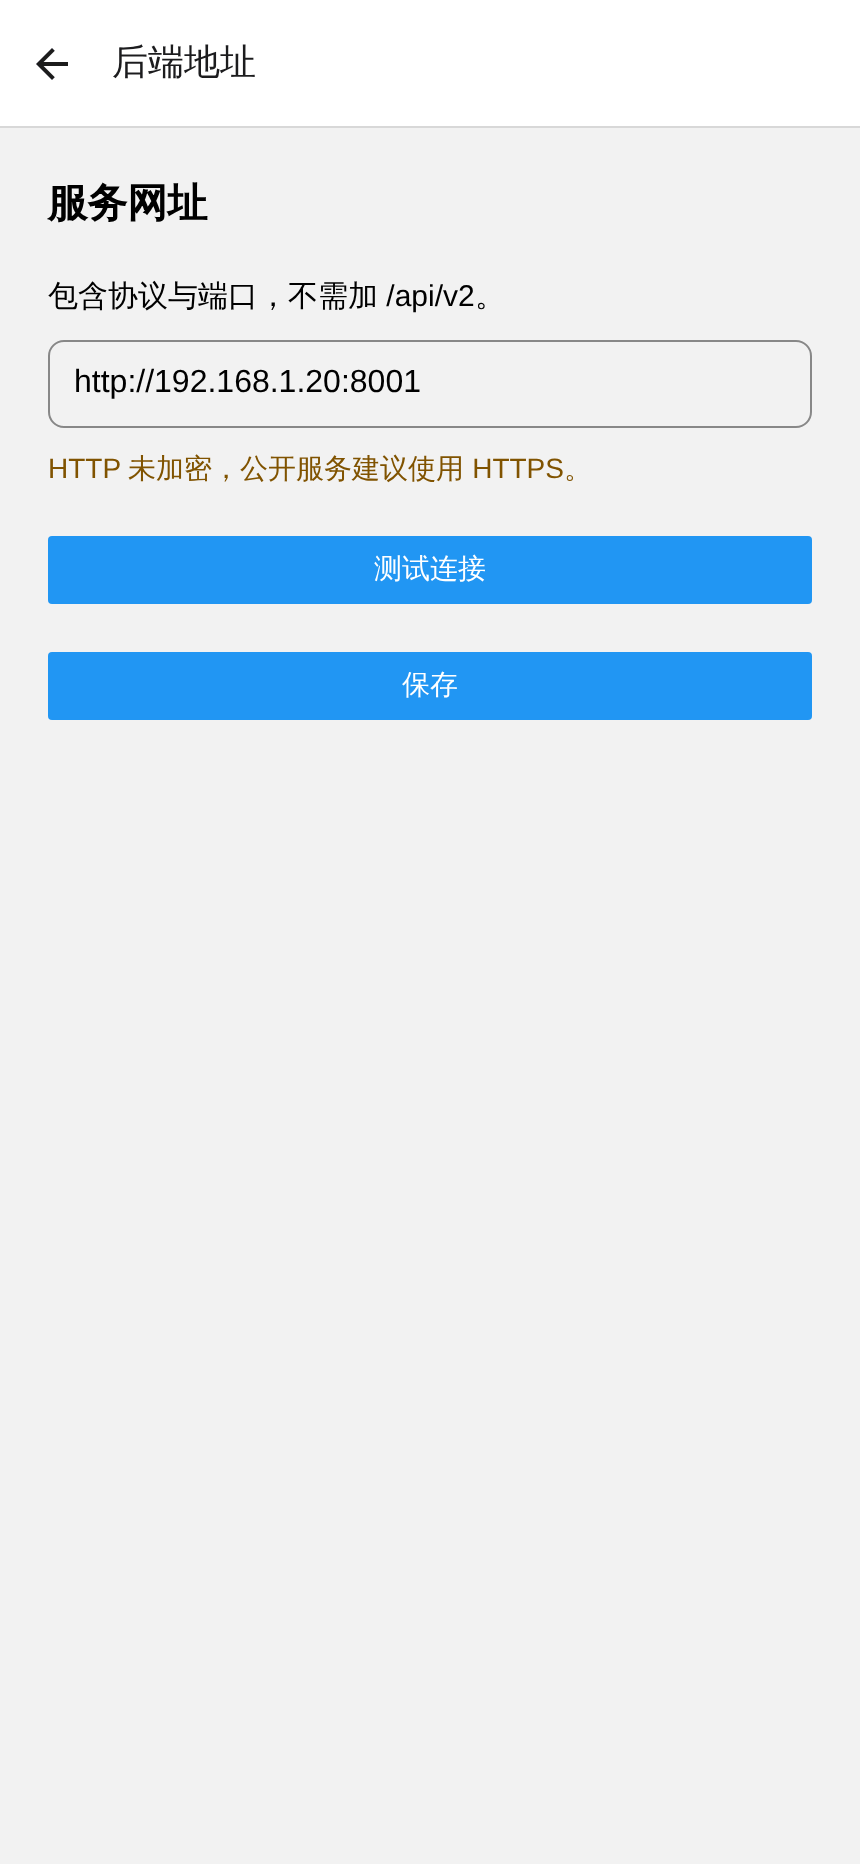
在“后端设置”中输入后端地址,提交数据前先测试健康和就绪状态;地址会保存在手机上。
支持四种语言
英语、繁体中文、简体中文和日语。
一条数据如何变成分数
- 1
测量
在采样点获取 DO、BOD、NH₃-N、EC 和 SS。
- 2
提交
应用将数值发送到 WQSurrogateModels API 的
/api/v2/assessment。 - 3
评估
API 校验输入后,用公式或你选择的模型计算 WQI5。
- 4
解读
应用显示 API 返回的分数、等级、分数区间、各指标状态和警告。
WQI5 公式
每项指标先换算为 0 到 100 的子指数,WQI5 是五个子指数的等权平均值,保留三位小数。
WQI5 = (QDO + QBOD + QNH₃-N + QEC + QSS) ÷ 5
应用本身不计算分数,一律以 API 的结果为准,因此每个客户端得到的结果都一样。
WaterMirror 应用
基于 Expo 和 React Native 开发的 Android 应用
WQSurrogateModels API
FastAPI 服务,提供公式和训练好的模型
API 的运行环境
普通 x86 服务器或电脑
用 Docker 运行的 Jetson Nano 2GB(ARM64)
六个等级,各有适用用途
API 会把每个分数归入六个等级之一,应用再说明该等级的水适合哪些用途。
| 优良85 < WQI5 ≤ 100 | 可用于各种用途,加氯消毒后可直接饮用。 |
|---|---|
| 良好70 < WQI5 ≤ 85 | 可作为自来水水源,以及水产养殖、工业、游憩和灌溉用水。 |
| 中等50 < WQI5 ≤ 70 | 经特殊处理后可作为自来水水源;可养殖对水质要求较低的鱼类,并供工业、游憩和灌溉用水。 |
| 不良30 < WQI5 ≤ 50 | 仅适合灌溉或工业冷却。 |
| 糟糕15 < WQI5 ≤ 30 | 不会令人反感,可用于环境保护。 |
| 恶劣0 ≤ WQI5 ≤ 15 | 可能产生异味。 |
公式是基准,模型用于对比
五项指标齐全时,默认且作为基准的是 WQI5 公式。另外训练了六种回归模型来逼近公式,用于对比准确度和运行开销,也用于缺少指标的实验场景。
| 模型 | MAE | R² |
|---|---|---|
| XGBoost | 0.264 | 0.9996 |
| LightGBM | 0.288 | 0.9995 |
| Random Forest | 0.338 | 0.9990 |
| SVM | 1.916 | 0.9813 |
| Polynomial regression | 5.160 | 0.8995 |
| Linear regression | 7.556 | 0.7803 |
为五次重复划分的平均值。误差是相对数据集的 Score 列计算的;公式本身与该列也存在差距(MAE 6.07),原因仍在调查,因此模型误差更低并不代表比公式更正确。
研究数据集和训练好的模型文件不随项目公开。公式可以直接使用;模型需要在本地自行提供。
缺少一项指标时
公式需要五项指标齐全,但 BOD 需要五天的实验室检测,氨氮通常也要送实验室分析,现场数据经常不完整。研究测试了两种补救方式:只用现有指标重新训练模型,或先用其他指标把缺失的那一项补回来再评分。两种方式都在 10,714 条模型训练时未见过的数据上验证。
缺少 NH₃-N
使用 DO、BOD、EC、SS
可作为估计
- 不用它重新训练
- MAE 2.37R² 0.95
- 先从其他指标补齐
- MAE 2.40R² 0.95
缺少 BOD
使用 DO、NH₃-N、EC、SS
不可靠
- 不用它重新训练
- MAE 14.12R² −0.02
- 先从其他指标补齐
- MAE 12.14R² 0.10
缺少 BOD 和 NH₃-N
使用 DO、EC、SS
不可靠
- 不用它重新训练
- MAE 14.72R² −0.14
- 先从其他指标补齐
- MAE 12.89R² −0.01
MAE 以 WQI5 分数计,越低越好。R² 低于 0 表示比一律猜平均分还差。
氨氮可以由其他四项指标估算,误差约 2.4 分;BOD 不行,缺少它时误差会升到 12 至 15 分,所以 BOD 是必须测量的指标。
以上为研究结果;目前应用和 API 只对五项指标齐全的数据评分。
在 2 GB 的 Jetson Nano 上实测
同一套 API 用 Docker 运行在 Jetson Nano 2GB(四核 Cortex-A57)上,只使用 CPU 推理,模型训练不在设备上进行。
| 计算方式 | 第 95 百分位 | 中位数 |
|---|---|---|
| Direct WQI5 | 7.42 ms | 6.41 ms |
| XGBoost | 17.42 ms | 15.52 ms |
| LightGBM | 17.57 ms | 15.67 ms |
| Random Forest | 163.81 ms | 146.90 ms |
预热后的单条 HTTP 请求,经设备本地回环,MAXN 电源模式,每种方式 300 次。模型冷启动加载另行测量。
610 组中 597 组
重跑结果与 x86 一致
整套实验在 Nano 上重跑,并以绝对误差 1e-6 为阈值与 x86 对比。不一致的 13 组都是缺失指标重建场景下的线性和多项式模型,系数矩阵病态,会放大极小的浮点误差。
2.1.4 → 3.2.0
发现了分数错误
首次部署到 Nano 时用的是 XGBoost 2.1.4,模型能正常加载,分数却是错的。与 x86 参考结果对比时发现了问题,改为固定 3.2.0 后修复。
1.05 GB
随机森林最耗资源
这是正式版随机森林的模型文件大小。冷启动加载需要 168 秒,内存峰值 1.2 GiB,而设备只有 1.9 GiB。200 棵树的版本文件小了三分之一,误差只增加 0.33%,在完成完整验证实验之前仍作为候选。
快速开始
安装应用
下载 APK,打开“后端设置”,输入正在运行的 API 地址,例如 http://192.168.1.20:8001。
部署 API
需要 Python 3.10 或更高版本。只用公式时不需要任何模型文件。
git clone https://github.com/KageRyo/WQSurrogateModels.git
cd WQSurrogateModels
uv sync
uv run python main.py
运行时也已发布到 PyPI:wqsurrogatemodels。
从任意程序调用
任何 HTTP 客户端都可以调用应用所用的同一个接口。
curl -X POST http://localhost:8001/api/v2/assessment \
  -H "Content-Type: application/json" \
  -d '{"DO":70,"BOD":2,"NH3N":0.3,"EC":400,"SS":10,
       "model_type":"direct_wqi5"}'

{"score": 75.685, "category": "Good",
 "rating_range": "70 < WQI5 ≤ 85", ...}